RTX 30XX の「半分に絞られた Tensor コア」を解放する gpu-unlock が公開
2026.10.26gpu-unlock-hero.pngPC目次
2026年10月18日、GitHub に Zagitta/gpu-unlock というリポジトリが公開されました。GeForce RTX 30 シリーズ(Ampere)では FP16/BF16 演算の速さに上限がかけられていて、その上限を外す Linux カーネルモジュールです。公開から1週間ほどで Star は約6,900、フォークは700を超えました。Issue 欄には、世界中から「自分のカードでも動いた」という報告が毎日のように届いています。
ニュースでは「性能がほぼ倍」という見出しが目立ちます。実際に何をしているのか、本当に速くなるのか、危なくないのかが気になったので、ソースコードを読み、報告を集めてみました。
要約
- GeForce の Tensor コアは、FP16(FP32 累算)、BF16、TF32 の速度がファームウェアで半分に設定されている。同じチップを使うプロ向けカードは全速で動く。
- gpu-unlock は、NVIDIA の署名済みファームウェア「Booter」のバッファオーバーフロー脆弱性を突き、GPU の最上位権限で動く領域でレジスタを1つだけ書き換える。その結果、速度設定のレジスタをホストから書けるようになる。
- 行列演算(GEMM)の単体ベンチマークでは、同じ電力で +60〜80%。実際のアプリでは、画像生成、学習、LLM の prefill が +15〜60% ほど速くなる。LLM の decode と INT8 推論は変わらない。
- 出力はビット単位で同じだったという報告が複数ある。一方で、起動直後のハングや、電源容量の不足による不安定化も報告されている。
- Linux 専用で、カーネルのコマンドラインでオプトインする方式。
速度制限の理由
最初は「暗号通貨のマイニング対策だろう」と思っていましたが、調べると別物でした。
RTX 30 のマイニング対策は LHR(Lite Hash Rate)です。ドライバと VBIOS が Ethereum の Ethash の計算パターンを見つけると、ハッシュレートを落とします。Ethash の速さはメモリ帯域で決まり、Tensor コアの FP16/BF16 はほとんど使いません。LHR 版の RTX 3080 や 3070 でも gpu-unlock で同じように速くなっているので(#110、#137)、2つは独立した仕組みだと分かります。
今回の制限は、プロ向け製品との差別化と見るのが自然です。NVIDIA のホワイトペーパーに載っているピーク性能(スパース性なし)を並べると、そのことがはっきり分かります。
| カード | チップ | FP16(FP16 累算) | FP16(FP32 累算) | BF16(FP32 累算) | TF32 |
|---|---|---|---|---|---|
| GeForce RTX 2080 Ti FE | TU102 | 113.8 | 56.9 | - | - |
| Quadro RTX 6000 | TU102 | 130.5 | 130.5 | - | - |
| TITAN RTX | TU102 | 130.5 | 130.5 | - | - |
| GeForce RTX 3080 10GB FE | GA102 | 119 | 59.5 | 59.5 | 29.8 |
| GeForce RTX 3090 FE | GA102 | 142 | 71 | 71 | 35.6 |
| RTX A6000 | GA102 | 154.8 | 154.8 | 154.8 | 77.4 |
| A40 | GA102 | 149.7 | 149.7 | 149.7 | 74.8 |
単位は TFLOPS です。出典は Turing ホワイトペーパーと GA102 ホワイトペーパー(v2.0)の仕様表で、TITAN RTX の値は GA102 ホワイトペーパーにある RTX 3090 との比較表から取りました。
- GeForce だけ、FP32 累算が FP16 累算のちょうど半分になっている。プロ向けの Quadro、TITAN、RTX A6000、A40 は、どちらの累算でも同じ値。
- この傾向は Turing(RTX 20)から続いている。Ampere では BF16 と TF32 も同じように半分になった。
- gpu-unlock のソースも、プロ向け(GL)の型番を「すでに BF16 が全速だから」という理由で対象から外している。
ちなみに、報告されている実測値は仕様表とよく合います。RTX 3080 の解除前の BF16 は約64 TFLOPS で、仕様の 59.5 よりやや高くなっています。実際のブーストクロックが公称値より高いためです。解除後は約110 TFLOPS になり、FP16 累算の仕様値 119 に近づきます。
FP32 累算や BF16 は、AI の学習の速さを直接左右する精度です。ゲームで使う FP32 や、推論でよく使う INT8 には手を付けていないので、「学習するならプロ向けを買ってください」という線引きだと読めます。シリコンの限界ではなく、製品構成の都合で設けた制限です。
Booter の脆弱性を使って4バイトを書き込む仕組み
ソースは C で数千行ほどで、kernel/gpu_unlock/unlock_610.c が中心です。作者の解説 docs/How Ampere was unlocked.md と合わせて読むと、全体の流れは次のようになっています。
書き換えるレジスタ
| レジスタ | アドレス | 役割 |
|---|---|---|
FEAT_OVR_SM_SPD(SS0) | 0x0082381c | 4bit × 8 フィールド。DP、FFMA、FMLA16/32、IMLA0〜3 の発行レート |
FEAT_OVR_SM_SPD_1(SS1) | 0x00823820 | IMLA4 の発行レート |
FEAT_OVR_PLM | 0x00823804 | 上の2つに書き込める権限レベル。初期値 0xffffff8f |
各フィールドは、bit3 が「上書き有効」、bit2:0 が「速さ」(0 なら全速、1 なら 1/2)です。SS0 に 0x88888888、SS1 に 0x8 を書けば全速になります。ただし、PLM の初期値は「最上位の L3(Heavy Secure)しか書き込めない」設定なので、ホストから書いても無視されます。
Booter のバッファオーバーフロー
Ampere の起動では、ドライバが SEC2 という独立したセキュリティプロセッサで「Booter」を動かします。Booter は署名済みのファームウェアで、GSP-RM(GPU 上で動く本体のファームウェア)の署名を確かめて起動します。
この Booter には、受け取った署名データの長さを確かめずにスタックへコピーしてしまうバグがあります。本来 4KB の署名欄に 64,000 バイトのデータを渡すと、スタックが溢れて戻りアドレスを上書きでき、ROP(既存コードの断片をつなげて実行させる手法)が動きます。ROP に使うコードの断片は、NVIDIA が一時期公開していたデバッグ版 Booter を手がかりに見つけたそうです。デバッグ版は公開されているテスト鍵で暗号化されていたので、復号して中身を調べられました。
使われる「V67 ペイロード」は、意外なほど単純なものです。
64,000 バイトを 0x0000019c で埋め、19か所だけ固定値を置く
  0xF948: 0xFFFFFFFF   ← 書き込む値
  0xF960: 0x00823804   ← 書き込む先(FEAT_OVR_PLM)
  その他: スタックカナリア、戻りアドレス、ガジェットのアドレス、終端
このペイロードは、L3 の権限で FEAT_OVR_PLM = 0xFFFFFFFF を1回書くだけです。これで、SS0 と SS1 がホストから書けるようになります。
起動時の流れ
※概略のため、詳細はリポジトリで公開されている文書を確認してください。
モジュールは initramfs で NVIDIA ドライバより先に読み込まれ、カードごとに次の処理をします(gpu_unlock_610_unlock())。
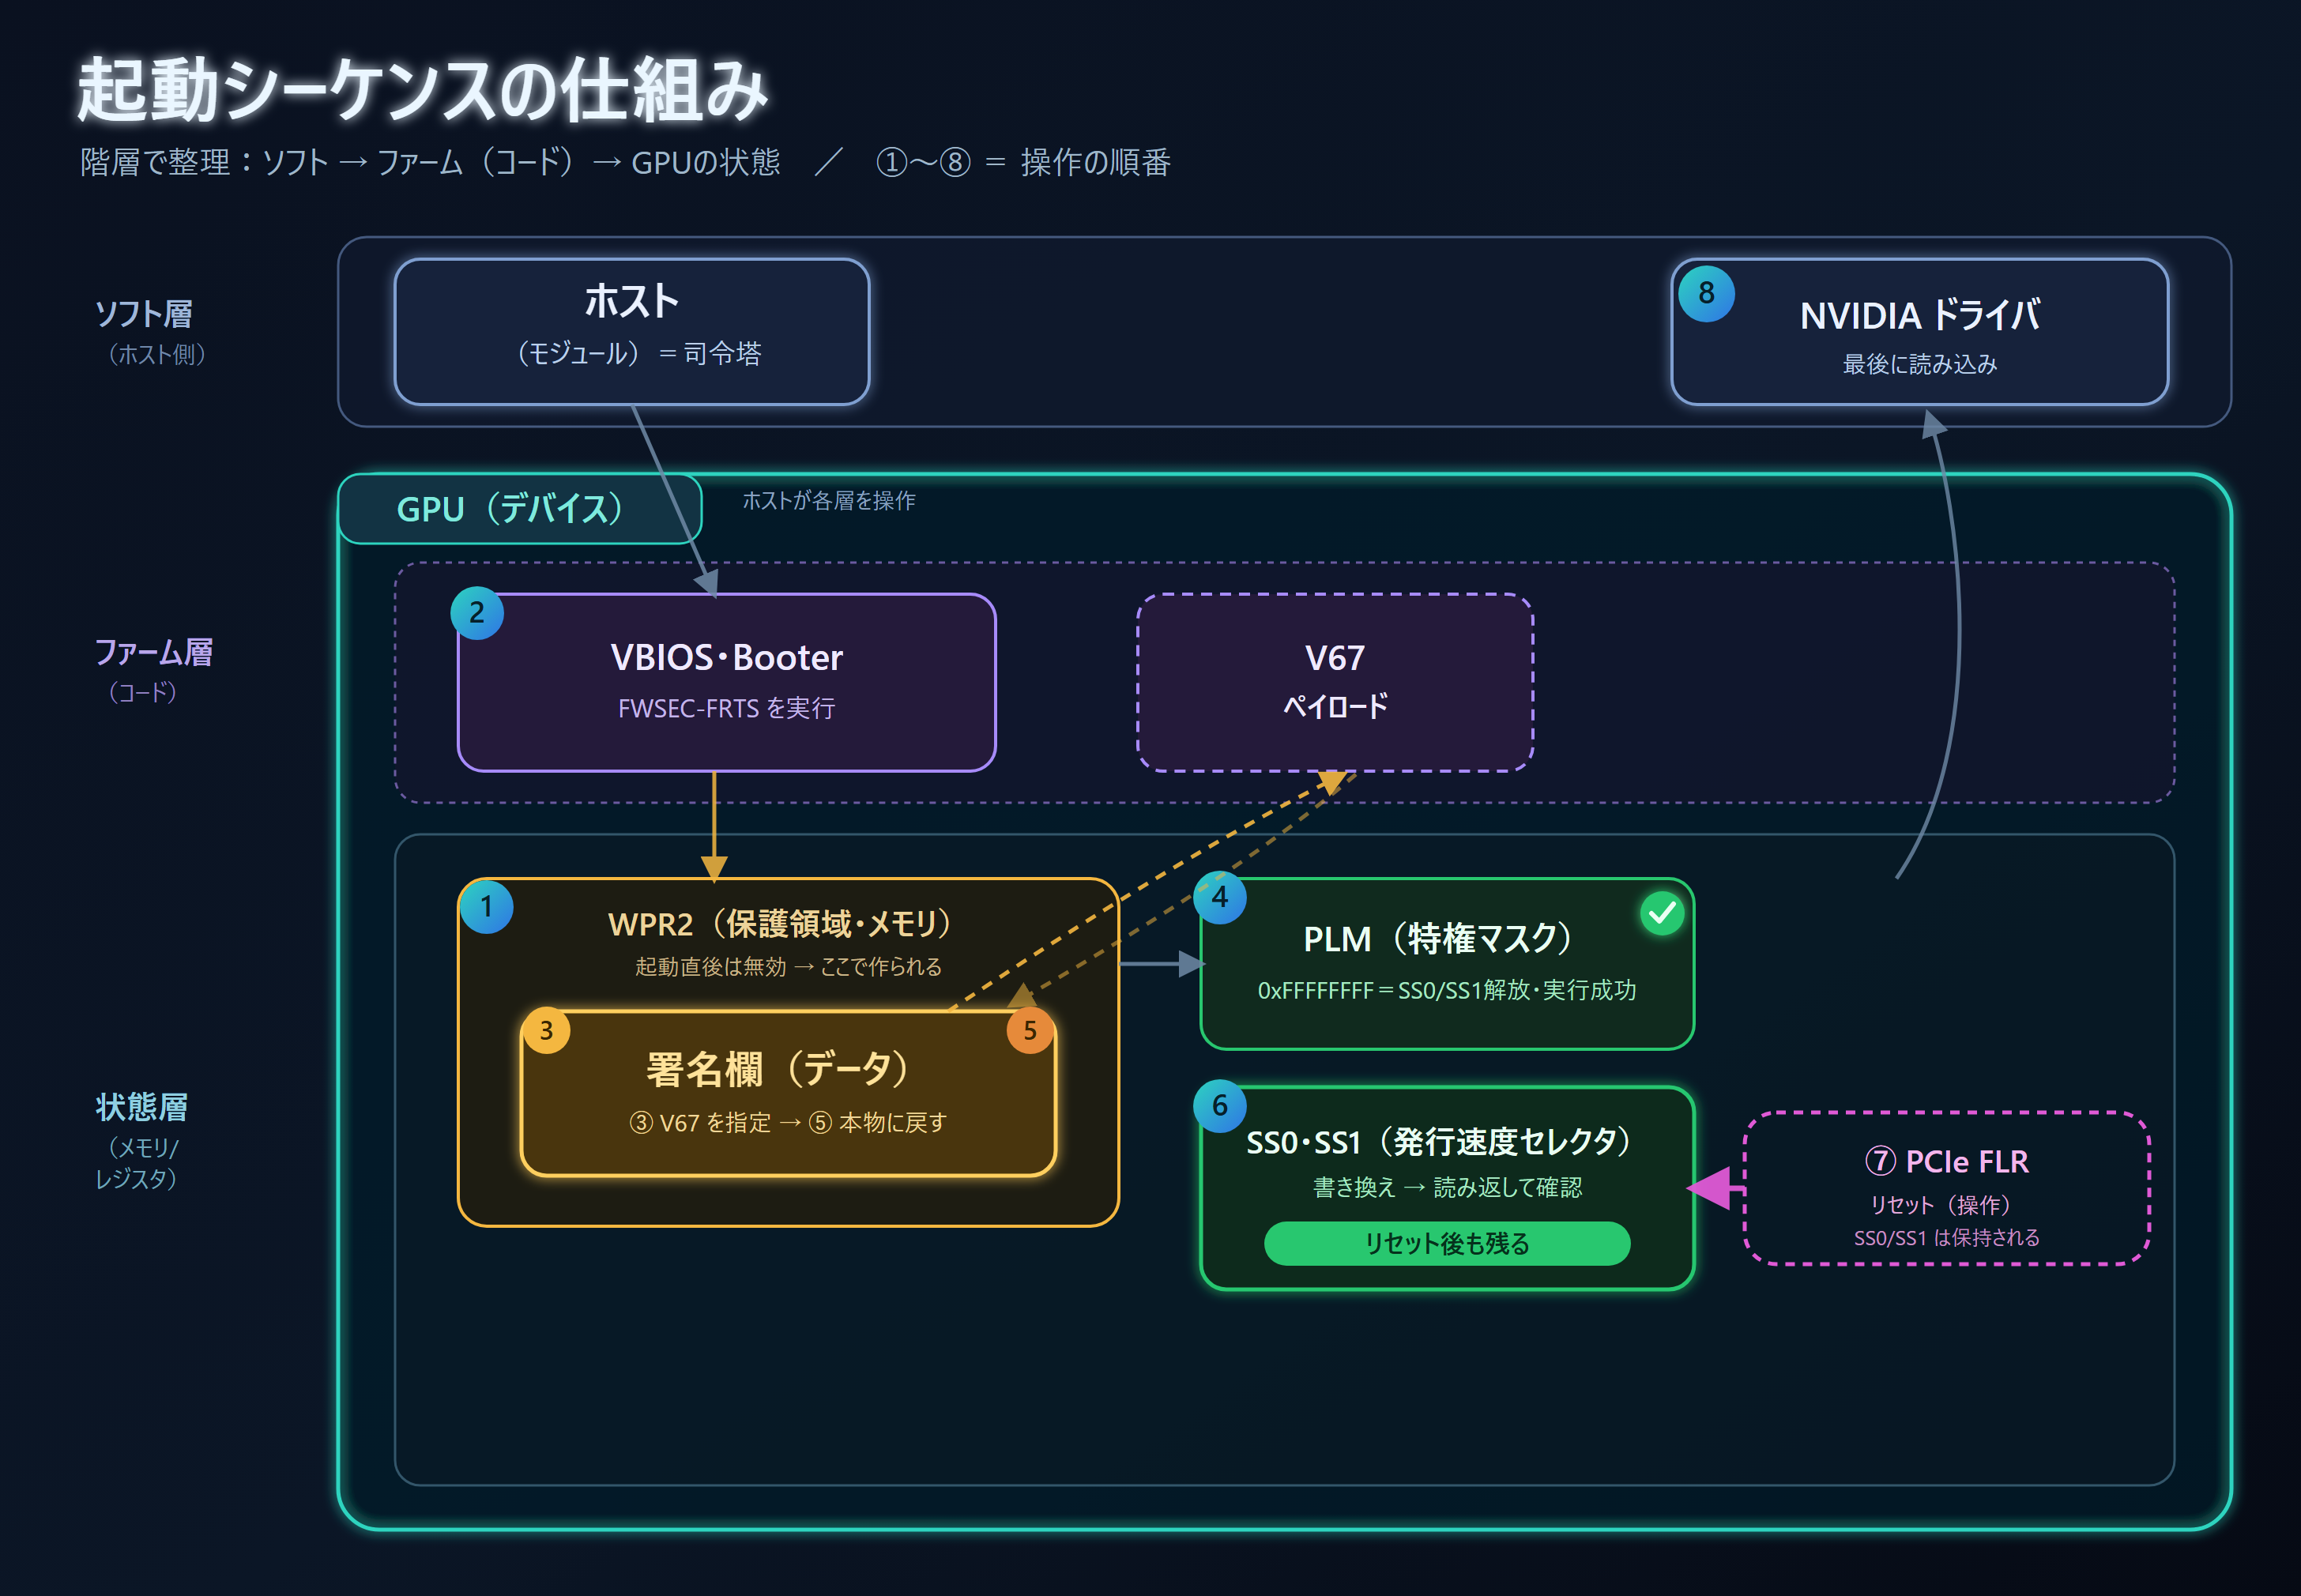
- カードが「電源投入直後で、どのドライバもまだ触っていない」状態かを確認する(WPR2 という保護領域が無効なら OK)。
- VBIOS から FWSEC-FRTS を取り出して実行し、WPR2 を作る(ここまでは正規の起動手順と同じ)。
- 起動情報(WPR メタデータ)の「署名」欄に、本物の代わりに V67 ペイロードを指定して Booter を起動する。
- PLM が
0xFFFFFFFFに変われば、ペイロードが実行されたと判断する。 - 署名欄を本物に戻す(失敗した場合も必ず戻す)。
- ホストから SS0 と SS1 を書き換え、読み返して確認する。
- PCIe FLR(カード単位のリセット)をかける。SS0 と SS1 の値はリセット後も残るので、GPU は「全速の設定のまま、まっさら」な状態に戻る。
- その後、普段どおり NVIDIA ドライバが読み込まれる。
ドライバは改造しておらず、VBIOS も書き換えていません。カーネルのコマンドラインから gpu_unlock.targets= を外せば、次の起動から元に戻ります。
コードは防御的に書かれていて好印象でした。たとえば、ファームウェアが止まらなかった場合は DMA バッファを解放せずに保持し続けます。失敗したときの扱いが丁寧です。ネットワークにアクセスするのは、ビルド時に NVIDIA 公式のソースと CachyOS の nvidia-utils パッケージをダウンロードするときだけで、どちらも SHA-256 で検証しています。
ドライバのバージョン
Booter や GSP のファームウェアは、NVIDIA 610.43.03 のものに固定されています。ただし、これはロック解除の処理だけで使うものです。その後に動くドライバのバージョンは問いません。 報告を見ても、580、595、610、615 系のドライバで動いています。
動作報告
Issue 欄には、決まったフォーマットの互換性報告が100件以上集まっています。代表的なものを拾いました(数値は各報告者の測定値です)。
行列演算ベンチマーク(GEMM)での性能
GEMM(General Matrix Multiply)は行列どうしの掛け算で、AI の学習や推論の計算量の大部分を占めます。ここでは、報告者たちが GEMM だけを繰り返して測った TFLOPS を並べました。条件はどれも、8192×8192 の行列どうしの掛け算(8192³)です。行列が大きいほど GPU の最大性能に近い値が出るので、上限を比べるときによく使われます。計算は FP32 累算で、掛け算は BF16 や FP16 で行い、途中の足し合わせは FP32 で持ちます。GeForce で速度を半分に絞られているのは、このモードです。
| カード | 電力上限 | BF16 前 → 後 | 備考 |
|---|---|---|---|
| RTX 3090 Ti(README) | 450 W | 87.5 → 157.4 TFLOPS(+80%) | FP16 87.5 → 118.4、TF32 42.6 → 82.6 |
| RTX 3090(#85) | 420 W | +66% | FP16 +64%、TF32 +71%。ウォームリブートでも成功 |
| RTX 3080 10GB LHR(#110) | 320 W | 63.9 → 109.6(+71%) | FP32 は 21.0 → 21.0 で変化なし。出力はビット単位で同一 |
| RTX 3080 10GB(#14) | 320 W | 約65 → 110〜113 | Xid エラーなし、出力はビット単位で同一 |
| RTX 3080 Ti 12GB(#133) | 210 W | 50.8 → 60.6(+19%) | 300 W にすると 106.3 |
| RTX 3070 LHR(#137) | 270 W | +77〜84% | 後述のハングあり |
電力上限が低いと、伸びは小さくなります。 RTX 3080 Ti は 210 W では +19% でしたが、300 W に上げると、解除前の上限を大きく超えました。1クロックあたりの仕事量が倍になるので、すぐに電力の上限に達し、クロックが下がって相殺されるわけです。
実際のアプリ
- ComfyUI での画像生成(RTX 3090 Ti)は、BF16 のワークフローで +47〜59% だった(ComfyUI Wiki)。150枚を生成して、ピクセルが一致した。
- vLLM での LLM 推論(RTX 3090、#107)では、prefill が電力上限 250 W で +25%、375 W で +50% 速くなった。1トークンあたりの電力量は約2〜3割減った。decode はどの電力でも変わらなかった。
- LoRA 学習(RTX 3090 ×4、#75)は、240 W 上限で +20〜24%、350 W で +49% だった。
- llama.cpp で量子化 GGUF を動かした例では、prompt processing も generation もほぼ変わらなかった(#133)。量子化モデルは INT8 の経路を通るので、当然の結果。
- Strata で Qwen3.8-Flash-Next の IQ3_S を動かした例(RTX 3090)では、prefill が約8%速くなり、decode は変わらなかった。別々の2件の報告で、ほぼ同じ結果が出ている(Strata #3858、gpu-unlock #71)。量子化による差もはっきりしていて、軽い IQ2_XS では +12.9%、重い UD-IQ4_XS では +1.5% だった。Strata はエキスパートの多くを CPU 側で計算するので、量子化が重いほど GPU の分担が小さくなるためと報告者は見ている。
- faster-whisper large-v3 による音声認識は +5〜7% だった(#137)。
行列演算が中心で、FP16/BF16 のまま回す処理(拡散モデル、学習、長いプロンプトの prefill)は速くなり、メモリ帯域で決まる処理や量子化モデルはほとんど変わりません。「ゲームが速くなる」という検証結果も、今のところありません。
うまくいかなかった報告、注意すべき報告
- 起動直後にハングした例がある(#137)。RTX 3070 LHR で、解除した5回の起動のうち1回、デスクトップが出てから約40秒後に、ログを残さずマシン全体が固まった。残りの4回、合計約75分は問題なし。報告者は「再現性はないが、初期化の競合の可能性は否定できない」と書いている。
- 電源容量が足りずに不安定になった例がある(#114)。RTX 3090 2枚を 850 W の電源で動かしたところ不安定になり、電源容量が原因と見られている。1600 W の電源を使う別の報告(#139)では、2枚同時の学習も問題なかった(最高温度は画面出力側のカードで 88℃)。
- ノート PC で、解除処理は成功するのに速くならない例がある(#124、#135)。595 系ドライバが、最初の CUDA プロセスの起動時に GPU を初期化し直していたのが原因で、
NVreg_GpuInitOnProbe=1を指定すると速くなった。 - OEM 版の RTX 3080 Ti 20GB は、解除は完了するが、BF16 は半分の速さのまま。
- mkinitcpio の systemd フックや、Ubuntu 26.04 の dracut で、モジュールが initramfs に入らないことがある(#14、#151)。報告が集まるにつれて修正が進んでいる。
広がり
- RTX 40(Ada)にも対応させる PR(#24)が出ている。RTX 4080 SUPER で FP16 が 110.6 → 202.7 TFLOPS になったという報告がある。まだマージされていない。
- Windows には、別プロジェクトの impacifist/Windows-GPU-UNLOCK が UEFI 方式で移植している。gpu-unlock の作者本人は「Windows 版はメンテナンスしない」とのこと。
- 中古相場について、wccftech は eBay で RTX 3090 の出品価格が跳ね上がっていると報じている(記事)。成約価格ではないので、割り引いて読む必要がある。
- Linux のメインラインに取り込む予定があるかという質問も出ているが、脆弱性を利用するという性質上、取り込まれる見込みはまずない(#138)。
NVIDIA の公式コメントは、今のところ見当たりません。
リスクをどう考えるか
「性能の限界だから絞っていた」わけではないので、解除しただけで壊れる、とは考えにくいです。それでも気になる点はあります。
- 電力と発熱が増える。同じクロックでも消費電力が上がる。電力上限はこれまでどおり機能するが、GeForce の高いクロック設定のまま全速で回したときの瞬間的な電流のピークや、VRM への負担は、NVIDIA がテストしていない領域。
- 計算の正しさは保証されていない。「ビット単位で一致した」という報告は複数あるが、GeForce 向けのチップが全速の条件で選別されているかは分からない。大事な学習では、解除前と解除後の結果を一度比べておきたい。
- 解除される範囲は BF16 だけではない。SS0 に
0x88888888を書くと、BF16 以外のフィールドもすべて全速の設定になる。各フィールドの意味は、観察から推測したもの。 - 手法そのものにもリスクがある。セキュアブートの脆弱性を使うので、保証が受けられなくなる可能性がある。起動時の失敗で電源を切るまでカードが使えなくなることもあるし、今後のファームウェア更新で塞がれる可能性も高い。NVIDIA のファームウェアには再配布の制約もある。
試すときの注意
Linux 専用です。入れるなら、最低限これだけは押さえておきたいと思いました。
- サブ機か、ブート項目を分けた環境で試す。GRUB に解除用のエントリを別に作り、
grub-rebootで1回だけ起動する方法なら、失敗しても戻しやすい。 - 電力上限は少し下げておく(
nvidia-smi -pl)。電源ユニットは、カードの電力上限の合計に余裕を持たせる。 - 起動したら
journalctl -k -b | grep gpu_unlockでunlockedの行を確認し、解除前と解除後で同じ GEMM ベンチマークを取る。 - 初回は GPU を使うサービス(Ollama など)を止めて起動すると、#137 のような競合のリスクを避けやすい。
まとめ
gpu-unlock は、「GeForce の Tensor コアは製品の差別化のために半分に絞られている」という、知っている人は知っていた事実を、誰でも確かめられる形にしたプロジェクトだと思います。行列演算が中心の AI 処理なら、同じ電力で大きく速くなり、電力効率も良くなります。ただ、その制限解除の仕組みは GPU のセキュアブートの脆弱性そのものです。今後 NVIDIA がどう対応するかも含めて、導入するかどうかは慎重に見極める必要があります。